Вечер. Телефон стоит на стопке книг, рядом лежит лист со сценарием ролика о своём деле. Человек читает первый абзац, спотыкается на слове и начинает сначала. Через несколько попыток абзац ложится ровно, и тут он замечает, что во втором абзаце устарела цена. Значит, завтра снова ждать тишины в квартире и снова читать с начала.
Озвучить текст своим голосом можно нейросетью по образцу. Вы один раз записываете чистую речь, сервис делает копию голоса, и дальше любой новый текст читается вашим тембром без микрофона. Хороший звук держится на трёх вещах: чистый образец, ударения прямо в тексте и проверка готового звука по кускам.
Мне такая копия нужна для рекламного ролика своей программы, и пока это задача, а не готовый результат: свой голос я ещё не клонировал. Зато я хорошо знаю, где такие системы ошибаются молча. Похожая беда случилась у меня с обратной задачей, когда нейросеть превращала длинные записи в текст.
Для короткого ролика хватает быстрой копии голоса
Копия голоса читает новый текст вашим тембром: сервис один раз слушает вашу запись и дальше говорит за вас. Копии бывают быстрые и профессиональные.
В справке ElevenLabs, одного из известных сервисов, для быстрой копии рекомендовано 1–2 минуты хорошей записи. Профессиональную копию сервис описывает как более точную, зато и записи она просит намного больше: минимум 30 минут, а лучше ближе к 2–3 часам.
Для минутного ролика я бы начал с быстрой. Если на пробном абзаце она звучит как вы, часы записи не понадобятся. Профессиональная копия окупает усилия там, где голос будут слушать долго, например в курсе из многих уроков.
Из России путей меньше, чем кажется: проверьте доступ до записи
Сначала стоит узнать, где вы вообще сможете сделать копию, иначе час записи уйдёт впустую.
ElevenLabs по своей справке закрывает доступ из России, официально в России он не работает. Другие способы доступа я здесь не разбираю.
У Яндекса есть SpeechKit Brand Voice: это услуга для бизнеса в облаке, а не кнопка в приложении. Полный вариант делают вместе с командой: по документации, специалисты Яндекса подбирают студию и диктора. Облегчённый вариант, где копия учится на ваших записях от 30 минут, на октябрь 2026 года отключён. В документации так и написано: «В связи с инцидентом функциональность отключена».
Простого и проверенного мной пути из России я назвать не могу. Порядок, который я бы прошёл сам: найти российский сервис озвучки с копией голоса и бесплатной пробой, а в пробе озвучить один абзац со сложными ударениями и один с числами. Если копия звучит не как вы или путает слова, запишите ролик сами: при редких правках это по-прежнему самый надёжный путь.
Копия повторит всё, что слышит в образце
Нейросеть копирует из записи тембр, манеру и заодно гул холодильника. В справке ElevenLabs качество записи названо самым важным: в записи один говорящий и нет фонового шума.
Как записать образец дома:
- Выберите самую тихую комнату с мягкими вещами: шторы, диван, ковёр. Голые стены дают эхо.
- Держите телефон или микрофон гарнитуры на расстоянии ладони и говорите одним и тем же тоном.
- Читайте текст, похожий на будущие ролики: для рекламы читайте рекламу, а не стихи.
- Сохраните запись в MP3 с качеством от 192 кбит/с, так советует та же справка. Если в диктофоне такой настройки нет, выберите самое высокое качество.
- Прослушайте запись в наушниках. Если слышно шум, щелчки или голос за стеной, запишите заново.
Плохой образец не исправит ни один сервис: копия повторит шум в каждой фразе.

Длинный текст озвучивайте по абзацам и сверяйте длину звука
Самая неприятная ошибка та, которую не слышно сразу. Я встретил её в своём транскрибаторе, программе, которая превращает длинные записи в текст через нейросеть.
Запись программа режет на куски. На длинных кусках нейросеть начинала повторять одно и то же слово, и я сократил куски до 1 минуты. Хуже было другое: пара кусков вернула по 4 символа текста, и программа посчитала это успехом. Снаружи расшифровка выглядела готовой, а в середине зияли дыры.
Теперь слишком короткий ответ программа считает браком и переделывает кусок. Бывало, что кусок получался только у третьей по счёту нейросети.
С озвучкой проверка та же, только в обратную сторону. Режьте сценарий на абзацы, озвучивайте по одному и сверяйте длительность звука с длиной текста: абзац на полстраницы не может звучать 2 секунды. Длительность файла видна в любом проигрывателе.
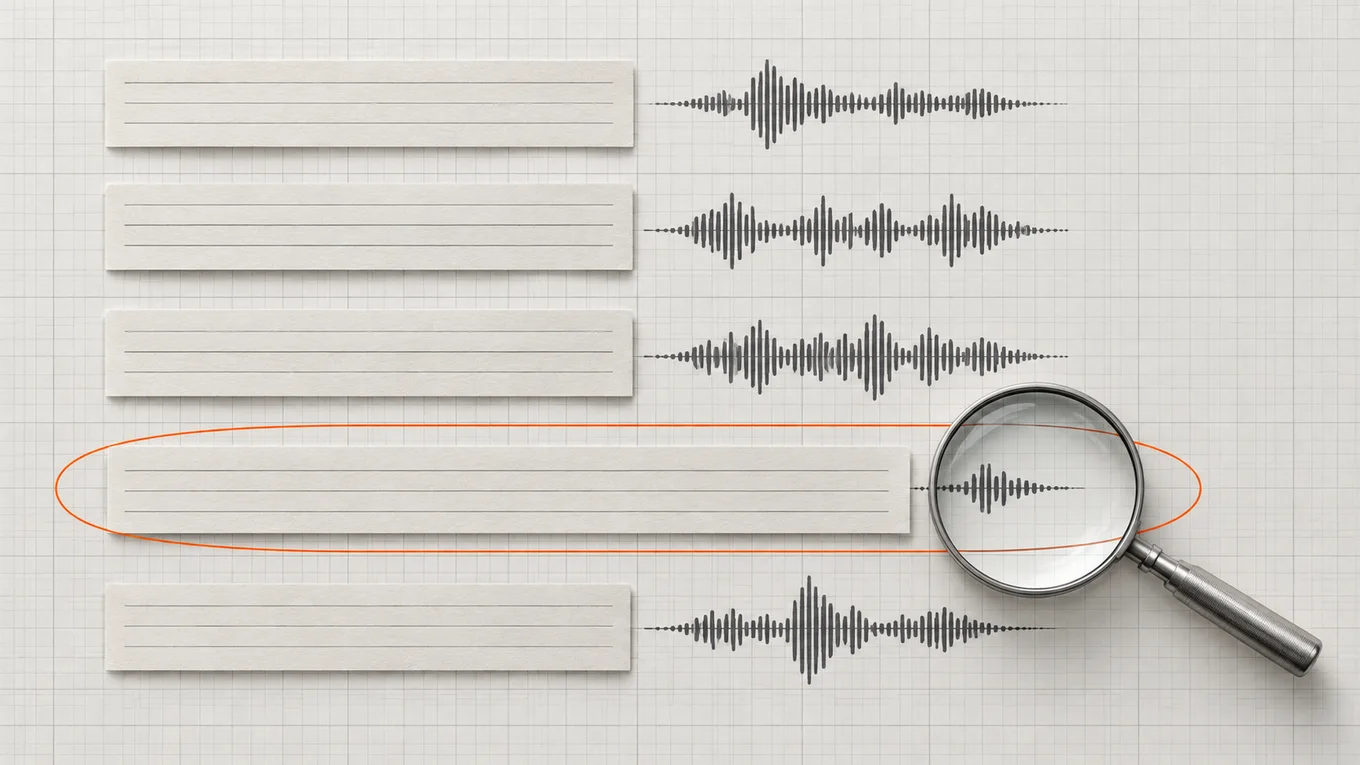
Каждый удачный кусок сразу скачивайте отдельным файлом с номером, например «03 цены.mp3». Этому меня научила моя диктовка: однажды она распознала длинную запись целиком, а текст напечатала не в то окно. С тех пор текст сначала сохраняется и только потом идёт дальше.
Если такую нарезку и проверку хочется отдать программе, такой инструмент я могу собрать под вашу задачу.
Ударения и числа правят в самом тексте
Копия голоса читает ровно то, что написано, а ударение угадывает по смыслу. «Замок» на двери и «замок» на горе пишутся одинаково, и угадывает она не всегда.
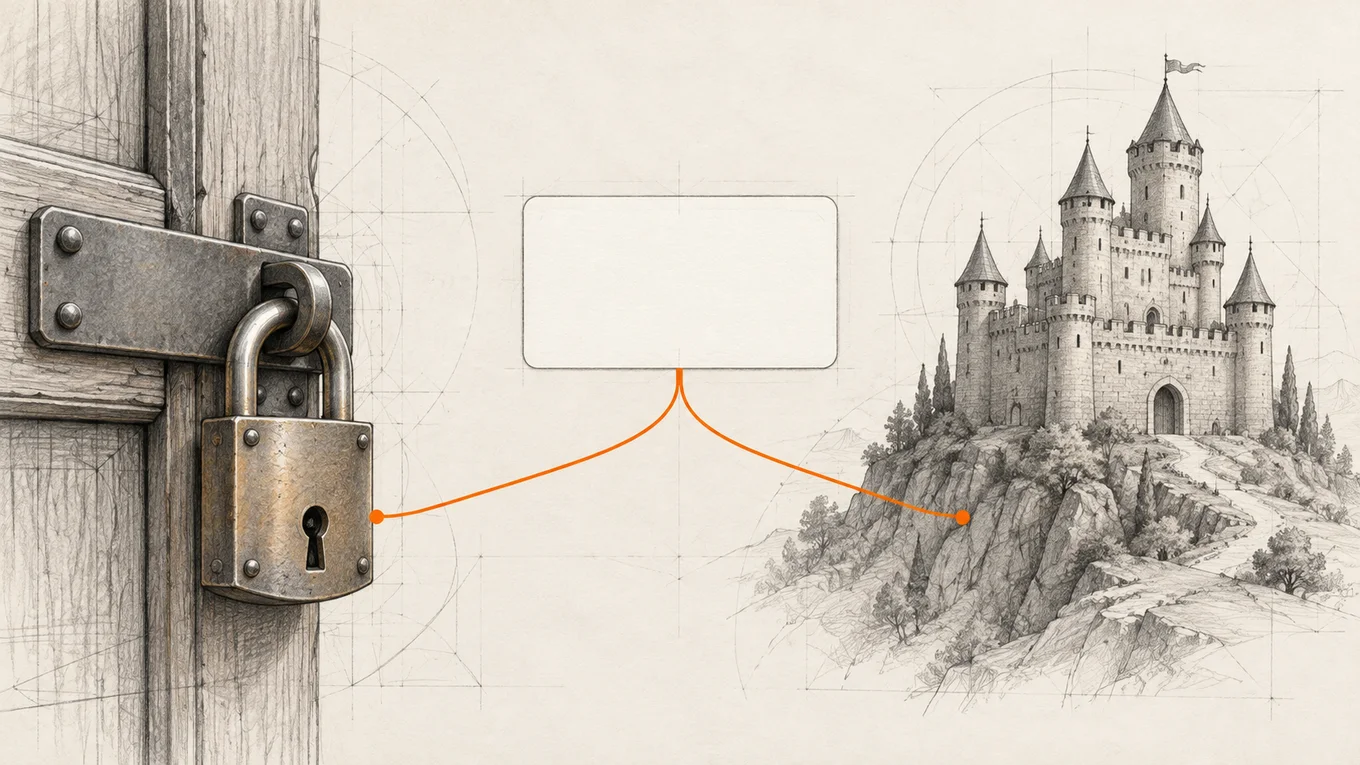
В синтезе речи Яндекса, по документации на октябрь 2026 года, ударение ставят знаком «+» перед ударной гласной: «зам+ок» прочитается как замок на двери, «з+амок» как замок на горе. Паузу задают вставкой между фразами: «Цены поменялись. sil<[500]> Теперь подробнее.» Число в скобках означает миллисекунды, 500 это полсекунды, предел 7000. Эти знаки понимает синтез Яндекса. В другом сервисе найдите в справке, как он ставит ударение.
Числа и даты пишите словами: «двадцать пятого октября», а не цифрами. Запись «2,5 %» сервис может прочитать как угодно, от «два пять» до «две целых пять десятых процента». Финальную версию слушайте целиком и следите глазами за текстом: зритель услышит всё, что пропустили вы.
Клонируйте свой голос и берегите образцы
Если чистый образец вашей речи окажется в открытом доступе, по нему можно сделать копию вашего голоса без вас, и ей поверят так же, как вам. Поэтому серьёзные сервисы проверяют, что запись ваша. В справке ElevenLabs сказано, что каждая профессиональная копия проходит проверку принадлежности: для этого в микрофон читают проверочные фразы.
Профессиональную копию этот сервис делает только из вашего собственного голоса: чужой голос так не клонируют даже с согласием его владельца. Это правило сервиса, а не закон, но логика понятна: тембр человека принадлежит ему.
Я бы держался трёх правил. Клонировать только свой голос. Образцы и готовую копию не выкладывать в открытый доступ. И честно говорить, что голос синтезированный, если зритель может принять его за живую запись.
Промпт: подготовить текст к озвучке своим голосом
Промпт, то есть текст-задание для чата с нейросетью, лежит ниже. Откройте любой чат с нейросетью, скопируйте блок, замените строку в квадратных скобках своим текстом и отправьте. Готовый результат вставляйте в сервис озвучки по одному куску. Если в тексте есть имена клиентов, телефоны или суммы, замените их до отправки. Знак «+» оставляйте, если ваш сервис его понимает; если нет, попросите выделять ударную гласную заглавной буквой.
Роль: ты редактор текстов для озвучки синтезированным голосом на русском языке.

Идеальный результат: текст, который синтезатор речи прочитает без ошибок в ударениях и числах, разбитый на куски по 1 абзацу.

Зачем мне это: я озвучиваю этот текст копией своего голоса для ролика и хочу, чтобы его не пришлось переделывать.

Задачи по порядку:
1) Найди слова, где ударение можно прочитать двумя способами (замок, мука, атлас, ирис), и поставь знак + перед ударной гласной по смыслу фразы.
2) Перепиши все числа, даты, проценты и сокращения словами так, как их нужно произнести.
3) Разбей длинные предложения: не больше 20 слов в одном.
4) Раздели текст на куски по 1 абзацу и пронумеруй их.
5) Отдельным списком выпиши места, где ты не уверен в ударении или произношении.

Нюансы: сохрани смысл и порядок мыслей, своих фраз не добавляй. Если слово иностранное, напиши рядом, как его произнести по-русски.

Рамки: только текст и список сомнительных мест, без пояснений.

Текст: [вставьте текст для озвучки]
Начните с одной минуты записи на телефон
Тот вечер с телефоном на стопке книг мог бы закончиться иначе: устаревшую цену поправили бы в тексте, а не у микрофона. Начать можно сегодня. Запишите на телефон 1 минуту образца в самой тихой комнате и прослушайте её в наушниках. Если в наушниках чисто, вам есть с чем идти в пробу сервиса.

Эльхан Дадашев, ИИ-архитектор. Собираю инструменты на ИИ под задачи людей, когда готовые программы не устраивают. В блоге разбираю нейросети для обычной работы на своих проверках.
Написать автору: Telegram · MAX · Работа со мной
Нужна такая же система под вашу задачу — разбираю процесс и проектирую её на ИИ.